Control de calidad en contenido escalado: audita lo que genera tu IA

Tienes una herramienta de IA que genera artículos en minutos. Tu pipeline funciona. El volumen sube. Y entonces aparece el problema que nadie menciona en los casos de éxito: ¿quién revisa lo que sale antes de que lo indexe Google?
El control de calidad en contenido escalado es el cuello de botella silencioso de casi todos los equipos que producen a volumen. No falla el modelo; falla el proceso que rodea al modelo. Y cuando falla, el coste no es solo editorial: una alucinación publicada daña la citabilidad de tu dominio en motores generativos, erosiona el E-E-A-T (expertise, experience, authoritativeness, trustworthiness) ante Google y, en el peor caso, crea un problema legal o reputacional.
La buena noticia es que un sistema de control de calidad robusto no tiene por qué ser lento. Tiene que ser selectivo y sistemático. Esto es lo que significa en la práctica.
Por qué el contenido generado por IA falla de formas predecibles
Antes de diseñar un sistema de control de calidad, conviene entender dónde falla la IA con más frecuencia. No es aleatorio. Los modelos de lenguaje cometen errores en patrones reconocibles, lo que significa que puedes anticiparlos y construir controles específicos para cada uno.
Alucinaciones factuales
El modelo genera texto que suena plausible pero contiene datos incorrectos: cifras inventadas, fechas erróneas, atribuciones falsas o afirmaciones que nunca ocurrieron. Las alucinaciones son el riesgo más grave porque el texto resultante es fluido y confiado; no hay señales de incertidumbre que alerten al revisor desatento.
La magnitud del problema está documentada: investigaciones sobre tasas de alucinación en LLMs (como las publicadas por el grupo de evaluación de Stanford HAI) estiman que entre el 15% y el 25% de las afirmaciones factuales generadas sin retrieval externo contienen algún tipo de inexactitud. El problema se agrava en temas con alta densidad de datos —estadísticas de sector, estudios, normativas— o en contenido sobre personas reales. Si tu herramienta cita un estudio, el control de calidad exige verificar que ese estudio existe y que la cifra que menciona es la que realmente contiene.
Degradación de E-E-A-T
El contenido generado tiende a ser genérico. Responde la pregunta obvia, pero omite la perspectiva de experiencia real que Google valora bajo el criterio de E-E-A-T. Un artículo sobre auditorías SEO escrito por IA puede ser técnicamente correcto y, aun así, no demostrar que quien lo publica ha ejecutado alguna vez una auditoría real.
Esto importa especialmente para la visibilidad en motores generativos como Perplexity o el AI Overview de Google: los sistemas RAG (Retrieval-Augmented Generation) que alimentan esas respuestas priorizan fuentes con señales de autoridad y experiencia demostrable. Un contenido genérico tiene menos probabilidades de ser recuperado como fragmento. Por eso el control de calidad debe incluir siempre una verificación de que el texto aporta perspectiva real, no solo información genérica. Si quieres profundizar en cómo optimizar para estos sistemas, el artículo sobre GEO y motores generativos desarrolla esta dimensión en detalle.
Inconsistencia de voz y estilo
Cuando produces a escala, distintos prompts generan distintos registros. El resultado es un sitio que suena a varios autores diferentes sin coherencia editorial. La inconsistencia de voz es un problema de marca, pero también es una señal de baja calidad editorial que los revisores humanos de Google pueden detectar. Un proceso de control de calidad eficaz incluye siempre la verificación del registro y la coherencia de estilo.
El modelo de tres capas para auditar sin perder velocidad
La trampa habitual es diseñar un proceso de revisión tan exhaustivo que anula la ventaja de velocidad que da la IA. El antídoto es separar el control de calidad en tres capas con distinta intensidad de esfuerzo humano.
Capa 1: validación automática (0 minutos de esfuerzo humano)
Hay comprobaciones de control de calidad que puedes automatizar completamente antes de que el texto llegue a ningún revisor. Define reglas en tu CMS o en tu pipeline de producción que bloqueen o marquen automáticamente los textos que incumplan criterios básicos.
- Longitud mínima y máxima por tipo de contenido (un artículo de 300 palabras cuando el brief pedía 1.200 es un error de pipeline, no de revisión).
- Presencia de la keyword principal en título, primer párrafo y al menos un H2.
- Detección de patrones de alucinación: frases como «según un estudio de 2023», «investigadores de la Universidad de…» o «el X% de los usuarios» sin fuente explícita deben activar una alerta automática.
- Score de originalidad con herramientas especializadas: Originality.ai combina detección de contenido IA con análisis de plagio en un solo pase; Copyscape es la referencia clásica para duplicados externos. Ambas tienen API para integrarse en pipelines automatizados.
Esta capa no reemplaza la revisión humana; filtra los errores más burdos antes de que consuman tiempo de revisión. En pipelines bien configurados, la Capa 1 rechaza o marca entre el 10% y el 18% del volumen generado antes de que llegue a un revisor humano. Es el primer nivel del control de calidad automatizado.
Capa 2: checklist pre-publicación (10-15 minutos por pieza)
Aquí entra el revisor humano. El objetivo no es reescribir el texto; es verificar los puntos que la automatización no puede resolver. Un checklist de control de calidad eficaz tiene entre ocho y doce ítems, no treinta.
Los ítems críticos de cualquier checklist de control de calidad para contenido generado por IA son:
- Verificación de hechos: cada dato numérico, cada cita y cada referencia a un estudio o normativa debe tener fuente verificable. Si no la tiene, se elimina o se reformula como inferencia.
- Coherencia con la intención de búsqueda: ¿el artículo responde realmente lo que busca quien teclea la keyword, o responde una pregunta adyacente?
- Voz editorial: ¿el registro es coherente con el del sitio? ¿Hay párrafos que suenan a plantilla genérica?
- Perspectiva de experiencia: ¿hay al menos un párrafo que aporte un punto de vista, un matiz o un ejemplo que solo alguien con experiencia real podría incluir?
- Estructura de encabezados: ¿la jerarquía H2/H3 es lógica y refleja la estructura del tema, no la del prompt?
- Enlaces internos y externos: ¿los enlaces que sugirió la IA existen y apuntan a donde dicen apuntar?
- Meta description y título SEO: ¿incluyen la keyword principal sin keyword stuffing y tienen la longitud correcta?
- Legibilidad: ¿hay párrafos de más de cinco líneas que deberían dividirse? ¿Hay frases pasivas acumuladas que ralentizan la lectura?
Para gestionar este checklist en equipo, Notion y Airtable son las opciones más usadas: ambas permiten crear formularios con casillas de verificación que el revisor debe completar antes de marcar la pieza como lista para publicar. El resultado es un registro auditable de cada pieza, no una lista mental que se olvida en momentos de alta carga.
Capa 3: auditoría profunda por muestreo (1 hora, cada dos semanas)
No puedes auditar en profundidad cada pieza que produces a escala. Pero sí puedes auditar una muestra representativa con regularidad. El muestreo es la clave del control de calidad sostenible: tomas el 10-15% del volumen publicado en las últimas dos semanas y lo sometes a una revisión exhaustiva.
En esa auditoría profunda evalúas dimensiones que el checklist rápido no cubre: ¿el contenido está generando señales de engagement? ¿Las páginas auditadas tienen tasa de rebote anormalmente alta? ¿Hay patrones de error recurrentes que indiquen un problema en el prompt o en la configuración del modelo? Una señal de alarma clara: si más del 20% de las piezas muestreadas requieren correcciones significativas, el filtro de Capa 2 no está funcionando y necesitas revisar el checklist o el brief de generación. Los patrones que encuentres en el muestreo alimentan mejoras en la Capa 1 y en la Capa 2, cerrando el ciclo de control de calidad.
Validación de fuentes: el punto más crítico del control de calidad
La validación de fuentes merece su propia sección porque es donde más equipos fallan y donde el daño es mayor. Un artículo con datos inventados no solo perjudica al lector; destruye la citabilidad del dominio en motores generativos, que aprenden qué fuentes son fiables a partir de señales de precisión y autoridad. Ningún proceso de control de calidad puede ignorar este punto.
Qué verificar y cómo
Cuando el texto generado incluye una referencia factual, el proceso de verificación —parte esencial del control de calidad— tiene tres pasos:
- Localiza la fuente primaria. Si la IA dice «según un informe de Gartner de 2023», busca ese informe específico. No asumas que existe porque el modelo lo menciona con confianza.
- Comprueba que la cifra es la que dice el texto. Las alucinaciones parciales son frecuentes: el estudio existe, pero la cifra que cita el modelo es incorrecta o está descontextualizada.
- Evalúa la vigencia. Un dato de hace cuatro años puede ser correcto históricamente pero engañoso si el lector lo interpreta como actual. Indica siempre el año de la fuente.
Si no puedes verificar un dato en menos de tres minutos de búsqueda, elimínalo. No es pesimismo; es higiene editorial. Un artículo con menos datos pero todos verificados tiene más valor que uno con diez cifras de las cuales tres son inventadas. Esta es la base de cualquier control de calidad riguroso.
El problema de las citas a personas reales
Los modelos de lenguaje atribuyen afirmaciones a personas reales con una fluidez que puede engañar incluso a revisores experimentados. Ninguna cita a una persona real debe publicarse sin verificación de la fuente original. Esto incluye directivos de empresas, investigadores, autores y cualquier figura pública. El control de calidad de citas es una de las tareas que no puede delegarse en la automatización.
La regla operativa es simple: si no tienes la URL de la fuente donde esa persona dijo exactamente eso, la cita no va. Puedes reformularla como paráfrasis no atribuida o eliminarla. El riesgo reputacional y legal de publicar una cita inventada supera con creces el valor editorial de cualquier cita.
Prompts de revisión asistida por IA
Puedes usar la propia IA para acelerar partes del control de calidad. Esto no es contradictorio; es usar la herramienta correcta para cada tarea. Un prompt bien diseñado puede pedirle al modelo que identifique afirmaciones factuales sin fuente, que señale párrafos con voz inconsistente o que liste los datos numéricos presentes para que el revisor los verifique uno a uno.
La IA no verifica hechos por ti; eso sigue siendo trabajo humano. Pero sí puede reducir el tiempo que tardas en identificar qué hay que verificar. La implicación directa es que el revisor dedica su tiempo a la verificación, no a la localización. Así, el control de calidad gana eficiencia sin perder rigor.
Estos son dos prompts listos para copiar y adaptar a tu pipeline:
Prompt 1 — Detección de afirmaciones sin fuente:
Analiza el siguiente texto y devuelve una lista numerada con TODAS las afirmaciones factuales que contenga: cifras, estadísticas, referencias a estudios, normativas, fechas o atribuciones a personas o instituciones. Para cada una, indica: (a) la afirmación exacta tal como aparece en el texto, (b) si incluye una fuente explícita (sí/no) y (c) el nivel de riesgo de alucinación (alto / medio / bajo) según la especificidad del dato. No verifiques si los datos son correctos; solo identifícalos para que un revisor humano pueda verificarlos como parte del control de calidad. Texto: [PEGA AQUÍ EL ARTÍCULO]
Prompt 2 — Detección de inconsistencias de voz:
Compara el siguiente artículo con el fragmento de referencia de estilo que te proporciono. Identifica los párrafos del artículo que presentan un registro diferente al de la referencia: más formal, más informal, más genérico, más pasivo o con un vocabulario distinto. Para cada párrafo problemático, cita las primeras palabras y explica en una frase por qué el registro no coincide. No reescribas nada; solo señala los problemas para que el editor los corrija. Fragmento de referencia: [PEGA AQUÍ UN PÁRRAFO REPRESENTATIVO DE TU ESTILO]. Artículo a revisar: [PEGA AQUÍ EL ARTÍCULO]
Ambos prompts funcionan con cualquier modelo de frontera (GPT-4o, Claude 3.5, Gemini 1.5 Pro). El segundo requiere que tengas un fragmento de referencia de estilo: un párrafo tuyo que represente bien la voz del sitio. Construir ese fragmento de referencia es una inversión de diez minutos que mejora todos los controles de voz posteriores.
Cómo escalar el equipo de revisión sin que el coste se dispare
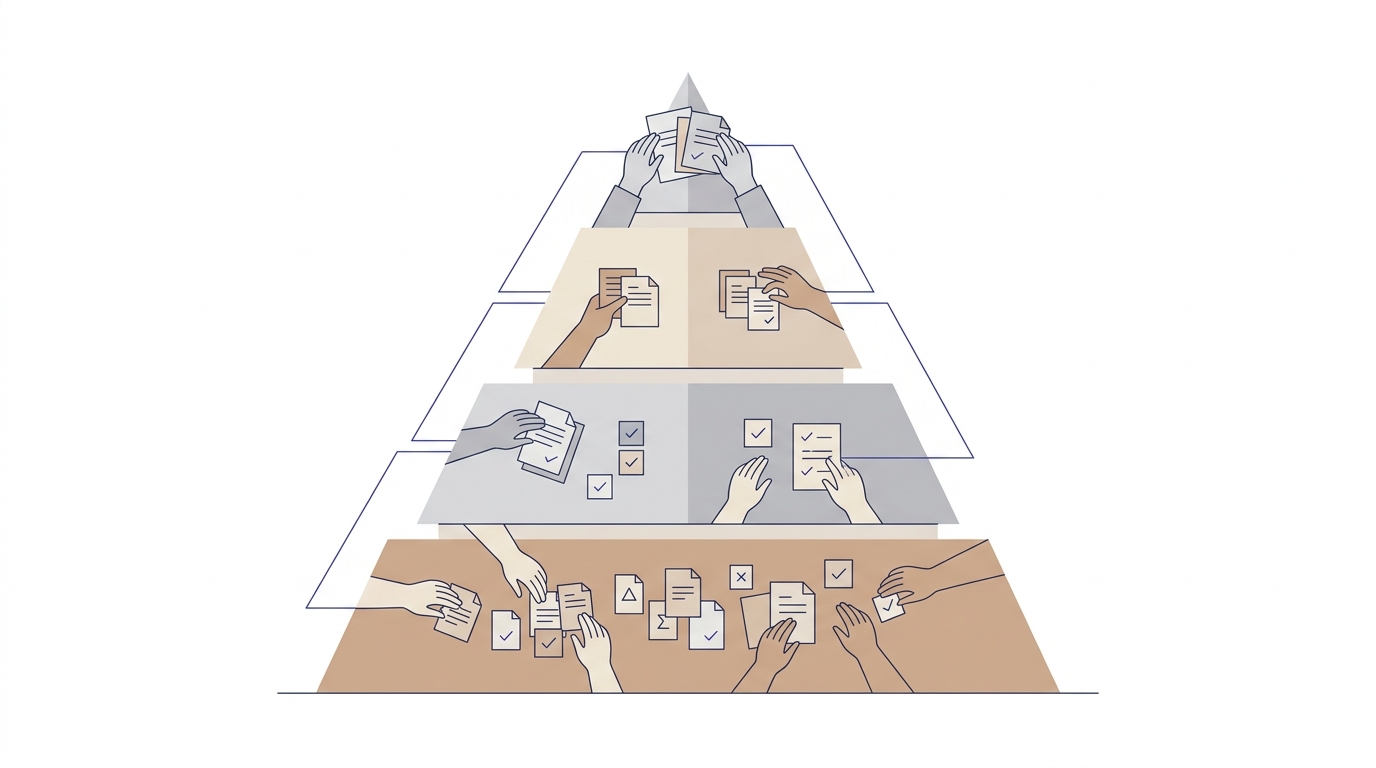
Si produces cien artículos al mes, necesitas un sistema de control de calidad que no requiera cien horas de revisión humana. La solución no es revisar menos; es revisar de forma más inteligente.
Especialización por tipo de revisión
No todos los revisores hacen lo mismo dentro del control de calidad. Puedes estructurar el equipo en dos perfiles con funciones distintas:
- Revisor de calidad técnica: verifica hechos, fuentes, estructura SEO y checklist pre-publicación. No necesita ser experto en el tema; necesita ser sistemático y tener criterio editorial.
- Editor de voz: interviene solo en las piezas que el revisor técnico marca como problemáticas en registro o coherencia editorial. Tiene menor volumen pero mayor profundidad de intervención.
Esta separación permite que el revisor técnico procese más volumen sin sacrificar la calidad de las piezas que requieren intervención editorial real. Además, hace más trazable el control de calidad: cada perfil es responsable de una capa concreta del proceso.
Umbral de intervención por tipo de contenido
No todo el contenido tiene el mismo riesgo. Define umbrales de control de calidad diferenciados según la tipología:
- Contenido YMYL (Your Money or Your Life: salud, finanzas, legal): revisión exhaustiva obligatoria, sin excepciones. Aquí el tiempo medio de revisión sube a 25-35 minutos por pieza.
- Contenido informacional de sector con datos y estadísticas: checklist completo más verificación de fuentes. Tiempo estimado: 15-20 minutos.
- Contenido evergreen genérico sin datos específicos: checklist reducido, revisión de voz y estructura. Tiempo estimado: 8-12 minutos.
Aplicar el mismo nivel de control de calidad a todos los tipos de contenido es ineficiente. Concentra el esfuerzo donde el riesgo es mayor. Para profundizar en cómo estructurar pipelines de producción con IA que integren estos umbrales desde el brief, ese artículo desarrolla la arquitectura completa del proceso.
Métricas para saber si tu sistema de control de calidad funciona
Un sistema de control de calidad que no se mide no mejora. Necesitas indicadores que te digan si el proceso está funcionando, no solo si el volumen sube.
Las métricas más útiles para auditar la eficacia del control de calidad del contenido generado son:
- Tasa de errores detectados en revisión: cuántos artículos de cada lote llegan con al menos un error factual o de voz. Si la tasa sube, el problema está en el prompt o en la configuración del modelo, no en la revisión. Una tasa por encima del 30% en Capa 2 es señal de que el brief de generación necesita revisión urgente.
- Tiempo medio de revisión por pieza: si sube de forma sostenida, el checklist está creciendo demasiado o el modelo está generando más errores. Ambas señales requieren intervención en el proceso de control de calidad.
- Porcentaje de piezas que pasan a Capa 3 (auditoría profunda): si más del 20% de las piezas muestreadas requieren correcciones significativas, el filtro de Capa 2 no está funcionando.
- Rendimiento SEO de contenido revisado vs. no revisado: si tienes datos históricos de piezas publicadas con distintos niveles de revisión, la correlación entre calidad del proceso y posicionamiento es la prueba más directa de que el control de calidad funciona.
Integrar el control de calidad en el flujo de producción, no añadirlo al final
El error de diseño más común en equipos que escalan con IA es tratar el control de calidad como una fase final separada del proceso de generación. Esto crea cuellos de botella y genera retrabajo. La calidad acaba dependiendo del estado de ánimo del revisor en ese momento, no del sistema.
La alternativa es integrar los controles de calidad en cada etapa del pipeline, no concentrarlos al final.
- En la fase de brief: el brief que alimenta al modelo debe incluir instrucciones explícitas sobre qué datos no incluir sin fuente verificada, qué registro usar y qué estructura de encabezados seguir. Un brief de calidad genera menos errores aguas abajo y facilita el control de calidad posterior.
- En la fase de generación: usa prompts de sistema que instruyan al modelo para marcar sus propias incertidumbres («no tengo datos verificables sobre esto») en lugar de inventar. Algunos modelos lo hacen si se les pide explícitamente.
- En la fase de revisión: el checklist pre-publicación es el control de calidad de esta etapa, no un paso adicional. Si el revisor no puede completarlo, la pieza no se publica.
- En la fase post-publicación: monitoriza las páginas publicadas durante los primeros treinta días. Si una página genera señales de baja calidad —tiempo en página muy bajo, tasa de rebote alta, ausencia de clics en resultados—, revísala aunque haya pasado el checklist.
La implicación directa de este enfoque es que el control de calidad deja de ser una barrera al final del proceso. Se convierte en una propiedad distribuida del pipeline: cada etapa tiene sus propios controles y ninguna descarga toda la responsabilidad en la siguiente.
Escalar contenido con IA sin un sistema de control de calidad es apostar a que el modelo no falle. Es una apuesta que perderás antes o después. La pregunta no es si vas a implementar controles de calidad; es si los vas a diseñar antes o después de que un error llegue a Google indexado.
Preguntas frecuentes
¿Cuánto tiempo debería dedicar a revisar cada artículo generado por IA?
Depende del tipo de contenido. Para contenido informacional estándar sin datos de alto riesgo, un checklist de control de calidad bien diseñado debería completarse en 10-15 minutos. Para contenido YMYL (salud, finanzas, legal) o piezas con alta densidad de datos y estadísticas, cuenta con 20-30 minutos de revisión más el tiempo de verificación de fuentes. Si una pieza requiere sistemáticamente más de 30 minutos, el problema está en el prompt de generación, no en el proceso de control de calidad.
¿Puedo usar IA para revisar contenido generado por IA?
Sí, pero con límites claros. La IA puede ayudarte a identificar afirmaciones sin fuente, señalar inconsistencias de voz o listar los datos numéricos presentes en el texto para que los verifiques. Lo que no puede hacer es asumir el control de calidad factual por ti: si el modelo dice que un estudio existe, otro modelo no puede confirmar que ese estudio es real. La verificación factual sigue siendo trabajo humano, sin excepciones.
¿Qué hago si detecto un error en un artículo ya publicado?
Corrígelo inmediatamente y actualiza la fecha de modificación del artículo. Si el error es factual y podría haber inducido a error a lectores (una cifra incorrecta, una cita falsa), añade una nota editorial breve al inicio del artículo indicando que se ha corregido y en qué consistía el error. La transparencia sobre correcciones refuerza la credibilidad editorial; ocultarlas la erosiona. Después, analiza por qué ese error pasó el control de calidad y ajusta el proceso.
¿Con qué frecuencia debo actualizar mi checklist pre-publicación?
Revísalo cada vez que detectes un tipo de error nuevo en la auditoría por muestreo. En la práctica, esto suele significar una revisión del checklist de control de calidad cada cuatro a seis semanas cuando el volumen de producción es alto. Un checklist que no evoluciona deja de capturar los errores que el modelo aprende a cometer de formas nuevas a medida que cambias prompts o herramientas.
¿Cómo afecta la calidad del contenido generado a la visibilidad en motores generativos?
Los sistemas RAG que alimentan motores generativos como Perplexity o el AI Overview de Google priorizan fuentes con señales de autoridad, precisión y citabilidad. Un dominio que publica contenido con alucinaciones frecuentes o datos no verificados genera señales negativas que reducen la probabilidad de que sus fragmentos sean recuperados. El control de calidad del contenido generado no es solo una cuestión de reputación editorial; es una variable directa de la visibilidad en GEO (Generative Engine Optimization).